Слух и аудио: частота, фаза, время и разрешающая способность слуха

Эта серия из двух статей посвящена спорным вопросам, связанным с аудио высокого класса, и сложному устройству человеческого слуха. Рассмотренные понятия помогают обоснованнее судить о том, что может иметь значение для максимально точного воспроизведения музыки, а что — нет.
Область воспроизведения музыки, известная как high-end audio (HEA), использует любые доступные средства, чтобы добиться звучания, максимально близкого к живому исполнению. Применяемые методы и материалы — например, атомные часы, алмазные диафрагмы и так далее — могут казаться чрезмерными и излишними. Разработка устройств предполагает небольшие последовательные изменения, оценка которых отчасти опирается на прослушивания, при которых участники знают, какое оборудование звучит, то есть на неслепые тесты.

Мельчайшие, порой весьма специфические искажения, которые стремится свести к минимуму HEA, выходят за рамки стандартных технических характеристик. Слышимость заявленных улучшений ставят под сомнение, поскольку зачастую она не подтверждена контролируемыми слепыми тестами. По совокупности этих причин вокруг HEA существует немало споров и скептицизма. Однако часть этого скептицизма основана на ошибочных представлениях о связи между временной и частотной областями и на недостаточном понимании работы слуха.

Рассмотренные здесь понятия помогают обоснованнее оценивать, что может иметь значение для воспроизведения музыки с наивысшей точностью. Кроме того, мы объясним, почему традиционные быстрые слепые сравнения A–B могут не срабатывать. За подробностями читатель может обратиться к недавно опубликованной обстоятельной обзорной статье [1], другим цитируемым работам и статьям на сайте автора.

Связь между частотой, фазой и временем

Значительная часть аудиосообщества неоправданно привержена формализму Фурье и чрезмерно полагается на описание звука через частотный спектр. Например, компонент, который не изменяет тембр [2], часто называют «нейтральным», подразумевая ровную амплитудно-частотную характеристику. Более подходящими определениями были бы «точный» или «естественный», поскольку компоненты HEA, за исключением акустических систем, обычно и так имеют достаточно ровную АЧХ. Искажения [3], влияющие на тембр, преимущественно связаны с временной областью — например, с точностью воспроизведения атаки и затухания звуков, — а не с частотным спектром. Прости, Фурье!

На рисунке 1 показаны спектрограммы трёх инструментов. По вертикали отложена частота, по горизонтали — время, а яркость и цвет соответствуют интенсивности. Обычно внимание сосредоточено на распределении энергии по спектру: у губной гармоники самый богатый спектр, плотно заполненный гармониками и другими обертонами; у фортепиано — наиболее чистый тон, в котором к концу затухания остаётся лишь основная частота; скрипка занимает промежуточное положение.

Есть и отчётливые различия во временной области: отдельные частотные составляющие по-разному нарастают и затухают. У скрипки основной тон начинается немного позже некоторых обертонов. У губной гармоники начало обертонов всё сильнее запаздывает с повышением их частоты. У фортепиано все обертоны возникают резко и одновременно. Кроме того, в начале фортепианного звука между обертонами виден шум — размытые участки, характерные для резкого импульса [4].
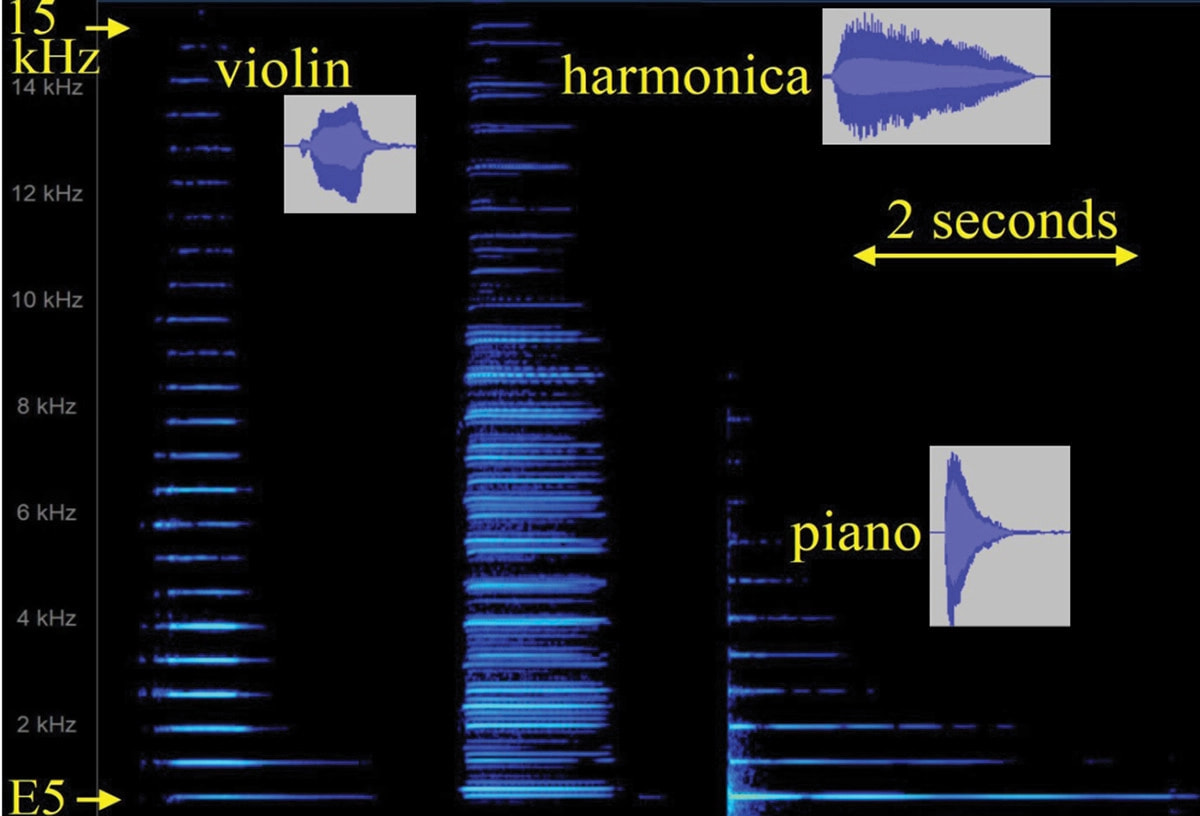

Рисунок 1: Спектрограммы одной и той же ноты — ми пятой октавы по международной нотации, E5, — сыгранной на указанных инструментах. На вставках показаны соответствующие формы сигналов: графики напряжения в зависимости от времени.

Вопреки распространённому мнению, сильнее всего на тембр влияют различия во временной области, а не различия спектров. Это показано в демонстрационном видео на YouTube [5], представленном на рисунке 2. При воспроизведении нот задом наперёд тембр резко меняется, хотя усреднённый спектр, рассчитанный по всему сигналу, остаётся в точности тем же [6]. Это показывает, насколько важны огибающая и временная структура для тембральной окраски звука.
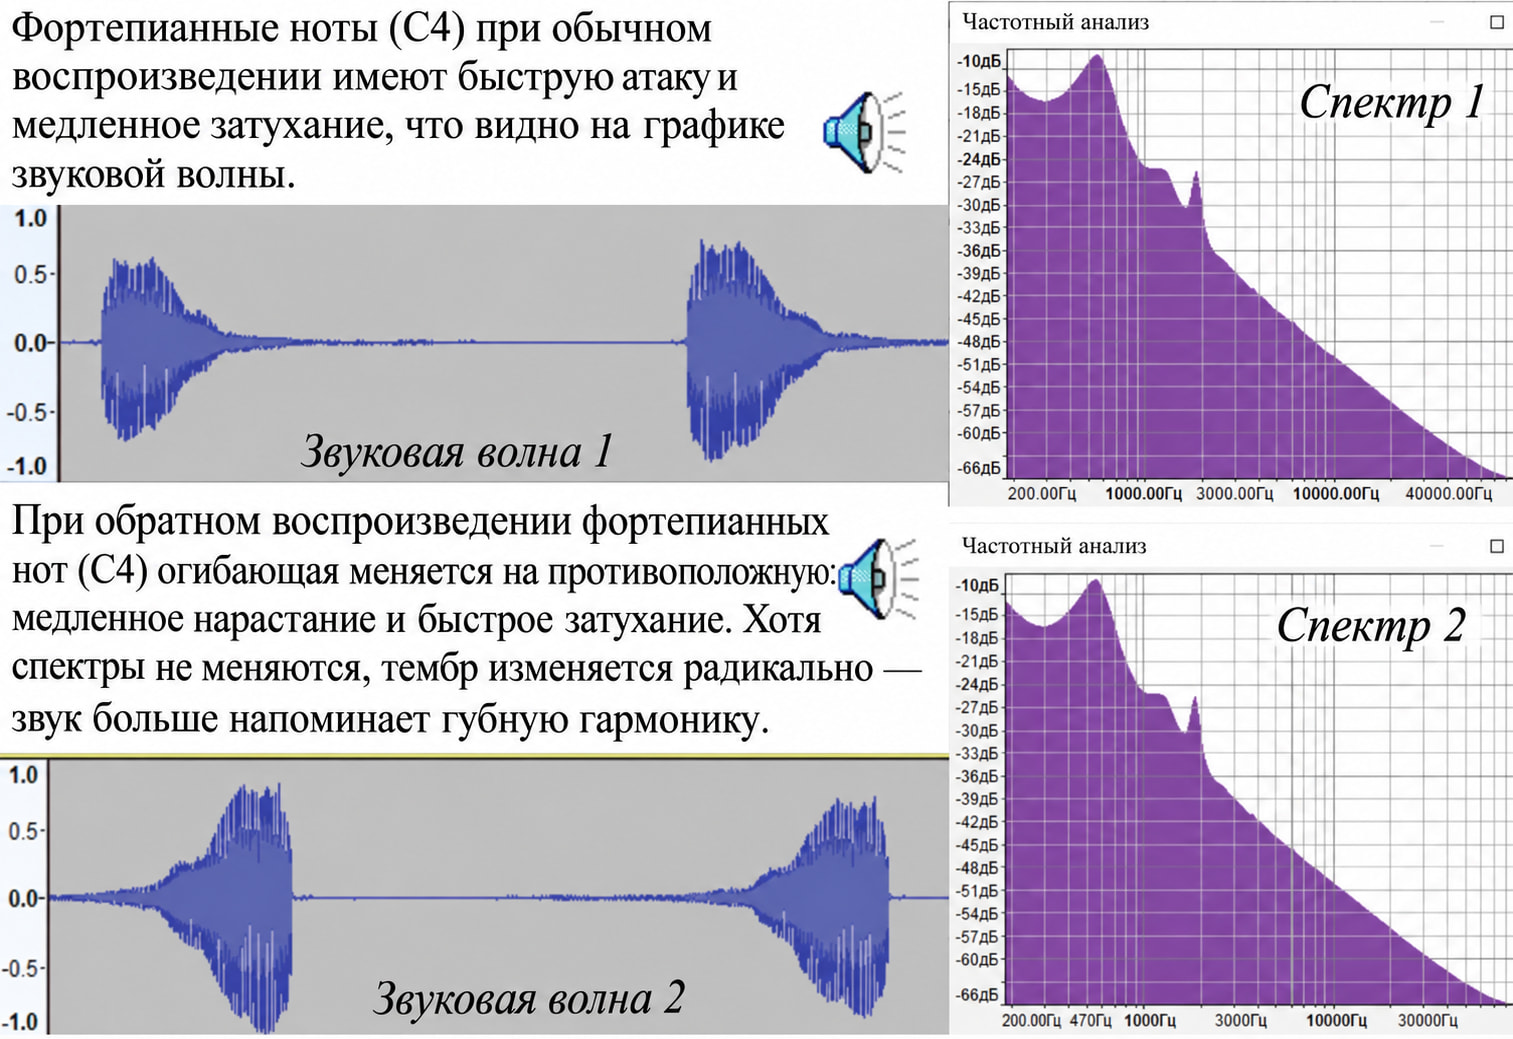
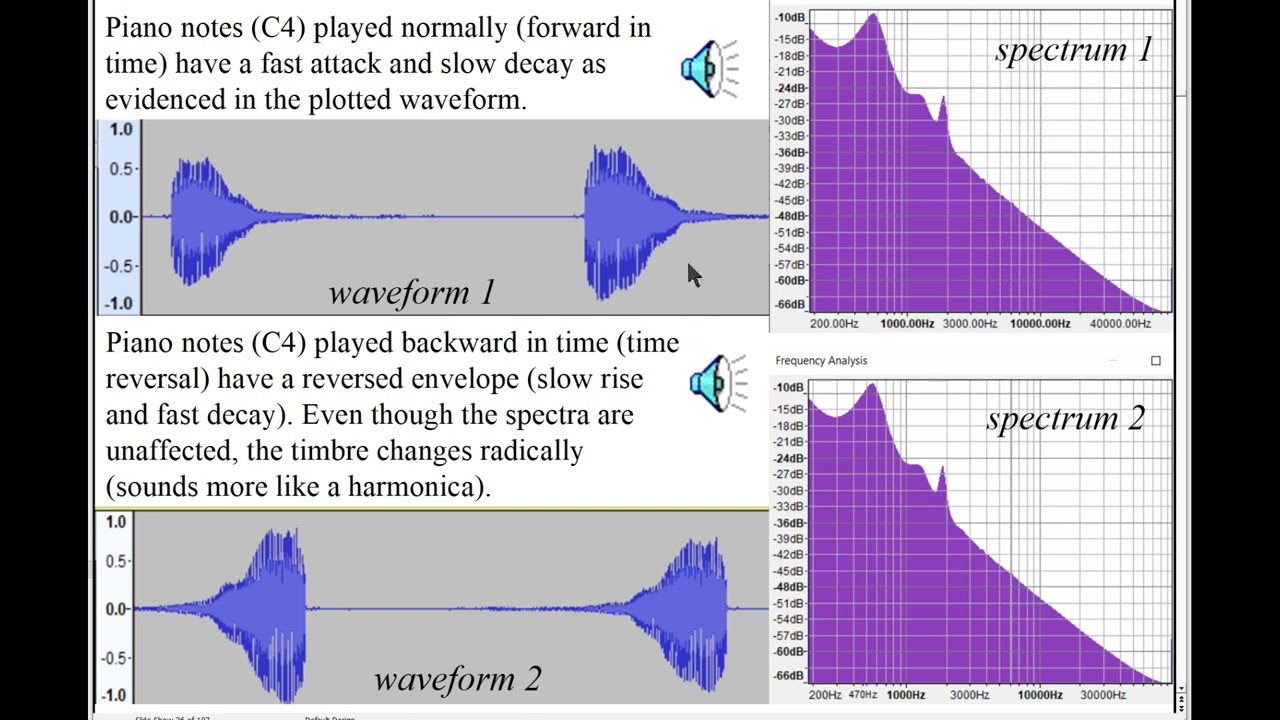
Рисунок 2. Демонстрация [5] изменения тембра при обращении времени. При обратном воспроизведении фортепиано по тембру несколько напоминает губную гармонику, несмотря на неизменность спектра.

Огромное значение тонкой временной информации, связанной с атакой и затуханием, наглядно продемонстрировал классический эксперимент К. У. Бергера [7], результаты которого приведены в таблице 1. Звуки различных духовых инструментов записали, а затем воспроизвели, слегка обрезав начала и окончания нот. Хотя усреднённый спектр практически не изменился, удаление начальных и конечных участков сделало инструменты неузнаваемыми даже для профессиональных музыкантов, хорошо знакомых с их звучанием. Например, шестеро приняли флейту за альт-саксофон, пятеро — за трубу и так далее.

Эти наблюдения подчёркивают важность временных характеристик аудиооборудования. Действительно, во многих конструкциях акустических систем стараются расположить акустические центры динамиков на одинаковом расстоянии от слушателя, чтобы правильно воспроизводить временные соотношения между частотными составляющими.
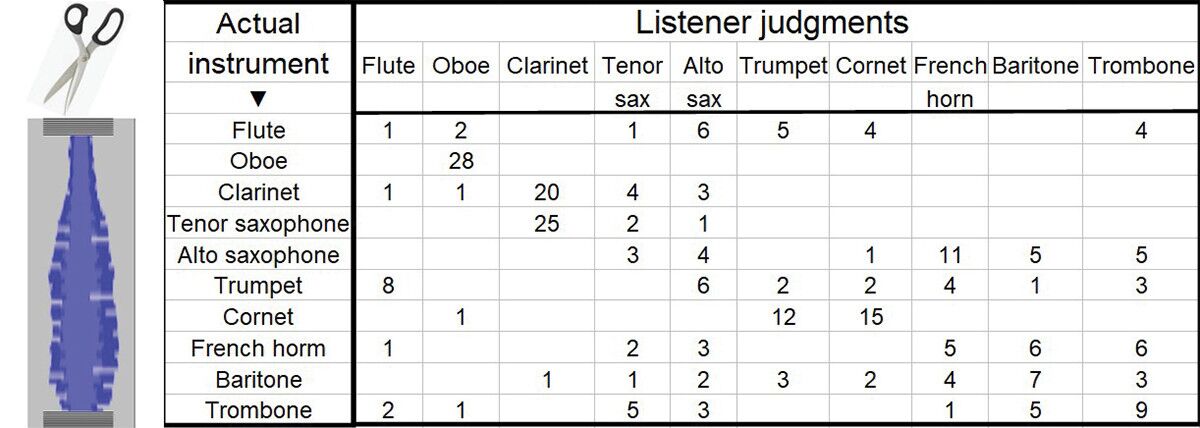

Таблица 1. Эксперимент Бергера с «матрицей ошибок распознавания». Удаление переходных процессов в начале и конце звука и небольшие изменения огибающей сильно затрудняли распознавание тембра. Следовательно, спектральных формант недостаточно для определения инструмента.

Временную задержку иногда путают с фазовым сдвигом. Это разные вещи, и в общем случае между ними вовсе не обязательно существует связь — за исключением отдельных, строго определённых ситуаций. Если два человека проходят через дверь, задержку между их появлениями можно измерить секундомером. Говорить о разности фаз для подобных непериодических событий бессмысленно [8].

Спектрограммы на рисунке 1 показывают относительные задержки начала частотных составляющих, а не просто фазовые сдвиги. Различие между фазой и задержкой показано в демонстрационном видео [9], представленном на рисунке 3. Стандартная смесь «A», в которой совпадают фазы и моменты начала составляющих, попеременно звучит со смесью «B», где фазы различаются на 90 градусов. На хорошей аудиосистеме разница едва слышна. Затем «A» чередуется со смесью «C», где начало второй гармоники задержано во времени, а не просто сдвинуто по фазе. В этом случае различие в характере звучания слышно отчётливее.
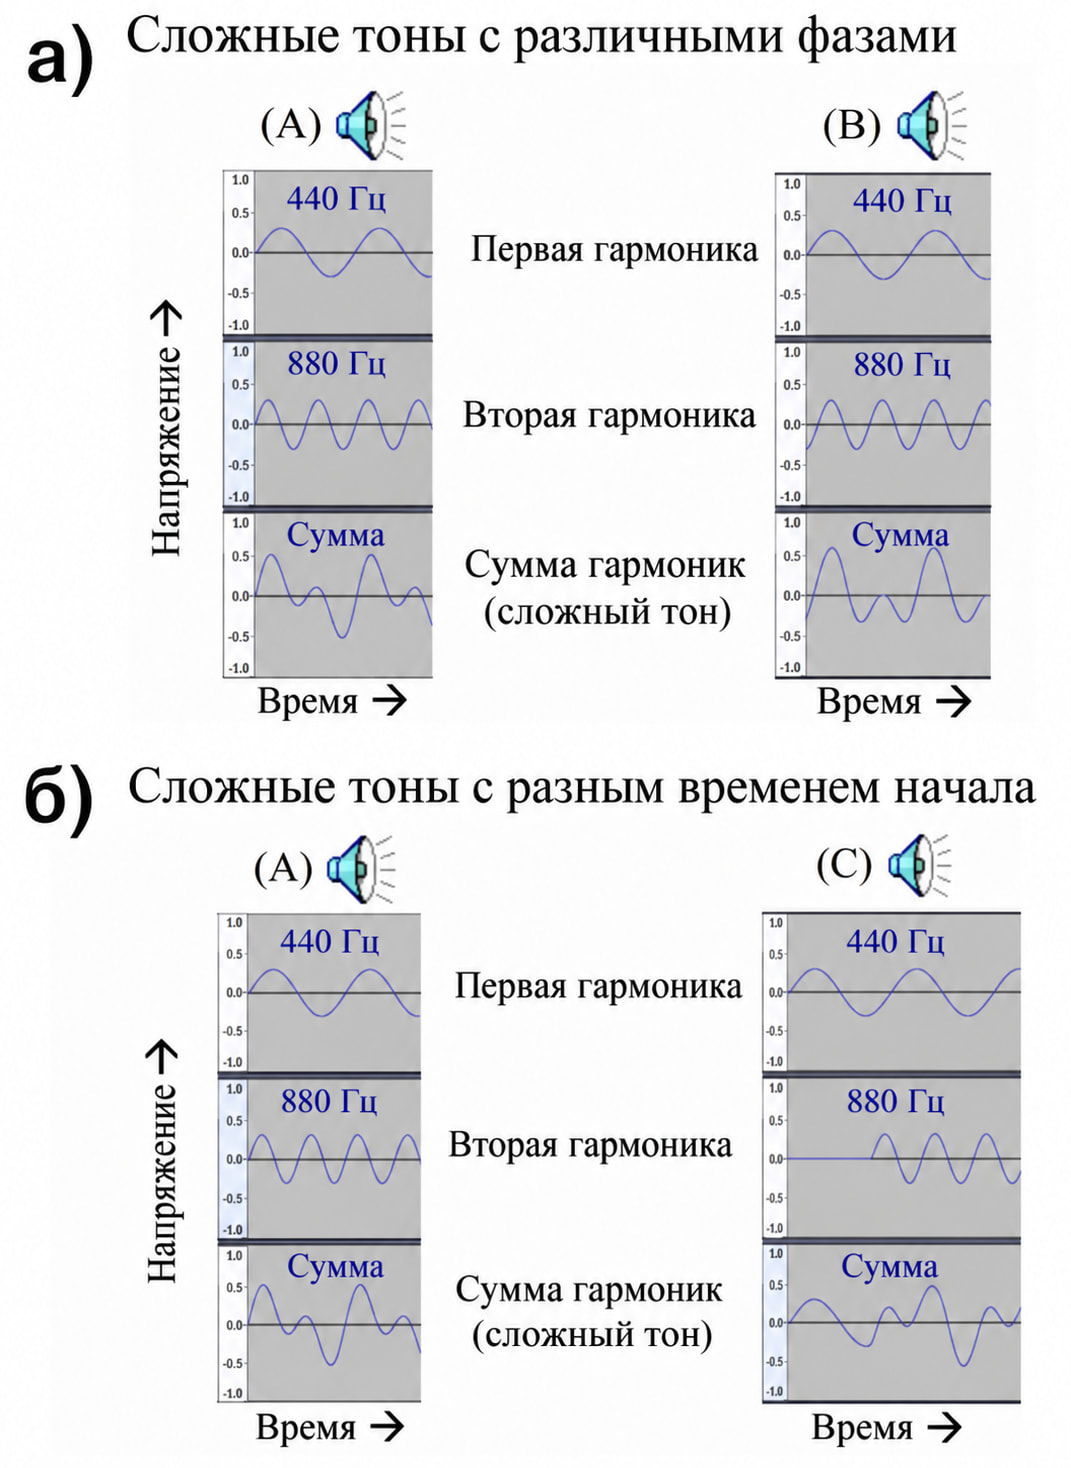
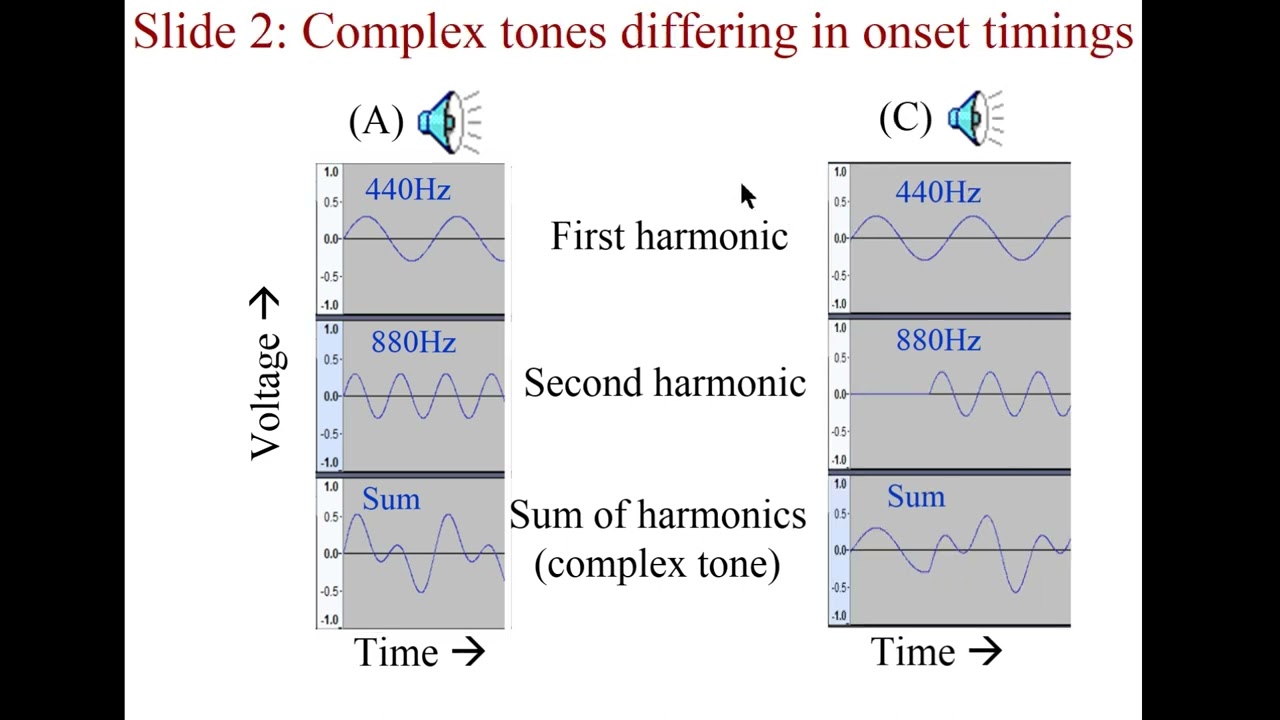
Рисунок 3. Демонстрационное видео [9] показывает, что тембр изменяется при временной задержке между гармониками — вариант (б), — но не при относительном фазовом сдвиге — вариант (а).

Таким образом, задержка между моментами начала составляющих существеннее, чем несовпадение фаз. Как уже упоминалось, во многих акустических системах HEA этому уделяют особое внимание. Независимость тембра от фазы настолько широко известна, что для неё существует отдельный научный закон — акустический закон Ома [10, 11, 12].

Временное размытие и разрешение в аудио

Физические системы с более быстрым откликом обычно лучше способны воспроизводить более высокие частоты и реагировать на них. Это справедливо, например, при сравнении высокочастотного и низкочастотного динамиков: более высокая резонансная частота сопровождается более быстрым возвращением к равновесию. Другой пример — RC-фильтр нижних частот: более высокая частота среза

f₍C₎ = 1/(2πRC)

означает меньшую постоянную времени затухания:

τ = RC = 1/(2πf₍C₎).

Однако между характерной частотой и характерным временем процесса не всегда существует простая обратно пропорциональная связь. Например, фильтры восстановления [13] при цифровом воспроизведении, имеющие наиболее короткий временной отклик, могут обладать менее протяжённой частотной характеристикой. Повседневные события нашей жизни — например, завтрак — «синхронизированы по фазе» с 24-часовым циклом. Но какое отношение продолжительность завтрака имеет к этой суточной периодичности? Никакого!

Точно так же человеку не обязательно лучше слышать высокие частоты, чтобы различать мельчайшие временные ошибки. Точность бинаурального различения временных сдвигов составляет 10 мкс при 700 Гц — это одна сотая периода T = 1,43 мс. При более высокой частоте, 1400 Гц, точность оказывается в десять раз хуже: более 100 мкс! Интересные нейрофизиологические особенности слуха, объясняющие отсутствие прямой связи между частотой, фазой и временем, а также основу закона Ома, рассматриваются во второй части этой серии.

Термин «временное разрешение» употребляют непоследовательно, обозначая им разные вещи. Для определённости мы будем использовать термин «временное размытие», обозначаемый τ, — размывание деталей переходных процессов, аналогичное оптическому размытию в телескопах. На рисунке 4а показано изображение звезды в телескопе: из-за дифракции вместо одной чёткой точки возникает картина Эйри. Две близкие звезды сливаются в одну, если угловое расстояние между ними меньше

θ₍C₎ = 1,22λ/d радиан,

где d — диаметр апертуры, а λ — длина волны. Это условие называют критерием Рэлея. Оно показано на профилях рисунка 4б.
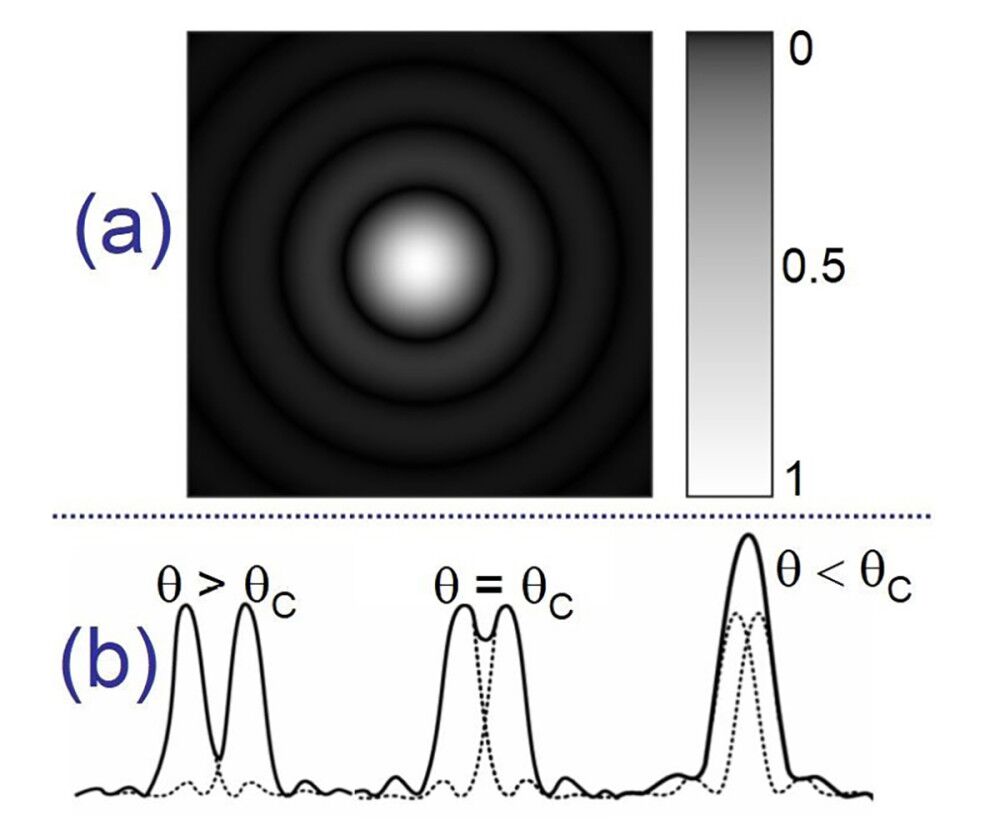

Рисунок 4. (а) Изображение звезды представляет собой размытую дифракционную картину Эйри. (б) Дифракционные профили двух близких звёзд перекрываются, и звёзды невозможно различить, когда угловое расстояние между ними θ < θ₍C₎ = 1,22λ/d. Рисунок адаптирован из источника [1].

Аналогичным образом каждый компонент аудиотракта размывает сигнал во времени, увеличивая общее τ системы. Два импульса, разделённые промежутком меньше τ, будут сливаться. Можно ожидать, что это повлияет на качество звучания, если τ превышает способность нашего слуха различать кратковременные события — временное разрешение переходных процессов, TR. Классические эксперименты Б. Лешовица [14] дали значение TR ≈ 4–10 мкс [15]. По аналогии с размытием изображений звёзд на рисунке 4, в этом психоакустическом исследовании измеряли способность слушателя различать одиночные и двойные импульсы одинаковой энергии, как показано на рисунке 5а.

Это объясняет, почему цифровое аудио с частотой дискретизации 44,1 кГц — стандарт Red Book, или уровень CD — недостаточно быстрое. На рисунке 5б показан сигнал напряжения на выходе ЦАП [16], когда входной WAV-файл содержит импульс длительностью в один отсчёт. Величина τ имеет порядок периода дискретизации и значительно превышает временное разрешение слуха. Чтобы уменьшить τ настолько, чтобы оно перестало быть ограничивающим фактором, потребуются существенно более высокие частоты дискретизации. Однако в большинстве аудиосистем слабые звенья найдутся и в других местах тракта. Если частота дискретизации не является главным ограничением системы, её повышение сверх 44,1 кГц может не дать слышимой разницы.
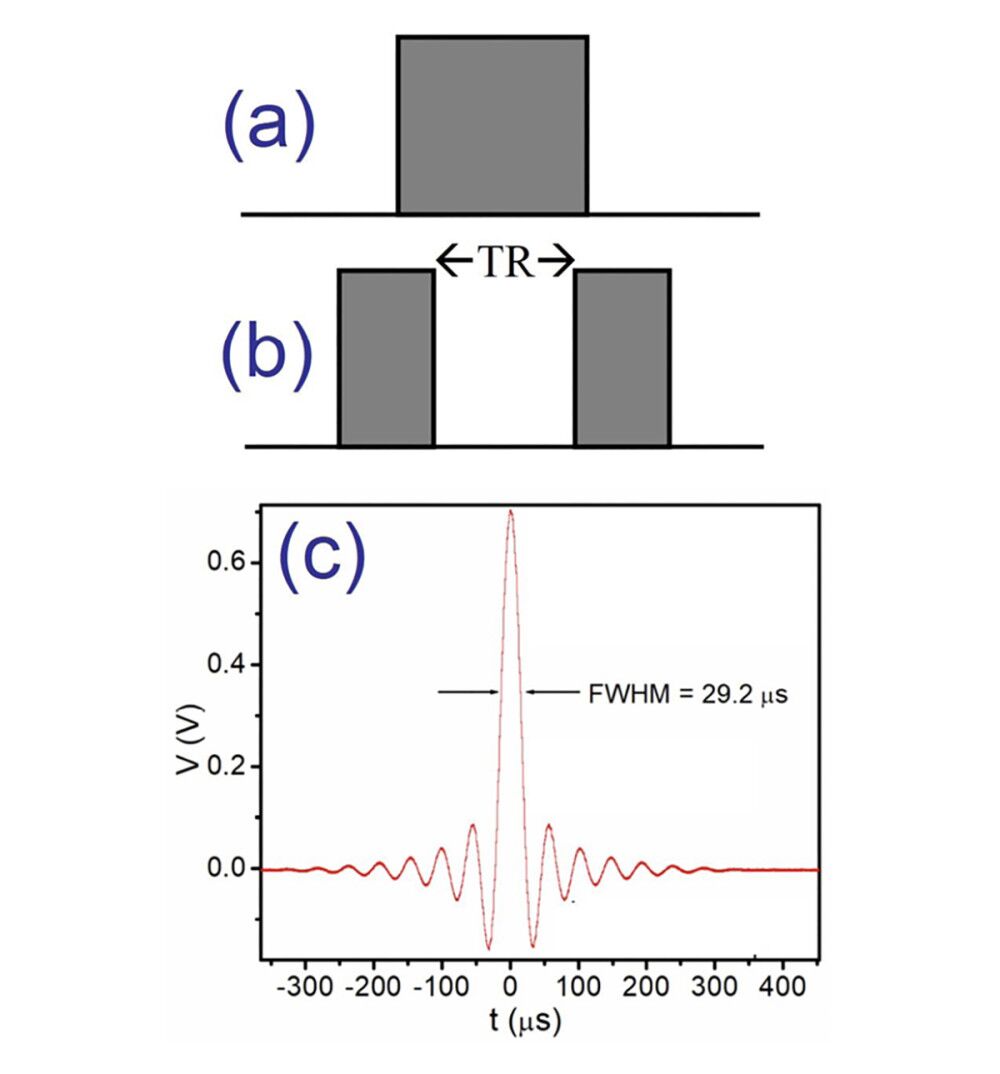

Рисунок 5. Эксперименты Лешовица [14] показали, что слушатели могли отличить одиночный импульс — (а) — от двойного — (б), — если промежуток между импульсами составлял TR ≈ 4–10 мкс. (в) Временное размытие цифрового аудио качества CD — 16 бит/44,1 кГц, — оцениваемое по полной ширине на половине максимума, FWHM, значительно превышает это TR. Рисунок адаптирован из источника [1].

Различение временного сдвига в цифровом аудио

В цифровом аудио существует величина

τ* ≈ 1/(2ᴺf₍S₎),

соответствующая порогу различения временного сдвига, то есть наименьшему сдвигу сигнала во времени, который можно обнаружить как изменение цифрового значения. Её смысл показан на рисунке 6. Для качества CD величина τ* составляет менее одной наносекунды [17]. Это очень малое значение иногда ошибочно называют «временным разрешением». Оно не имеет отношения к точности звучания. На рисунке 5в видно, какой искажённый отклик получается вместо задуманного бесконечно узкого импульса: он в сто тысяч раз шире субнаносекундного τ*, а слабые остаточные колебания продолжаются ещё дольше.
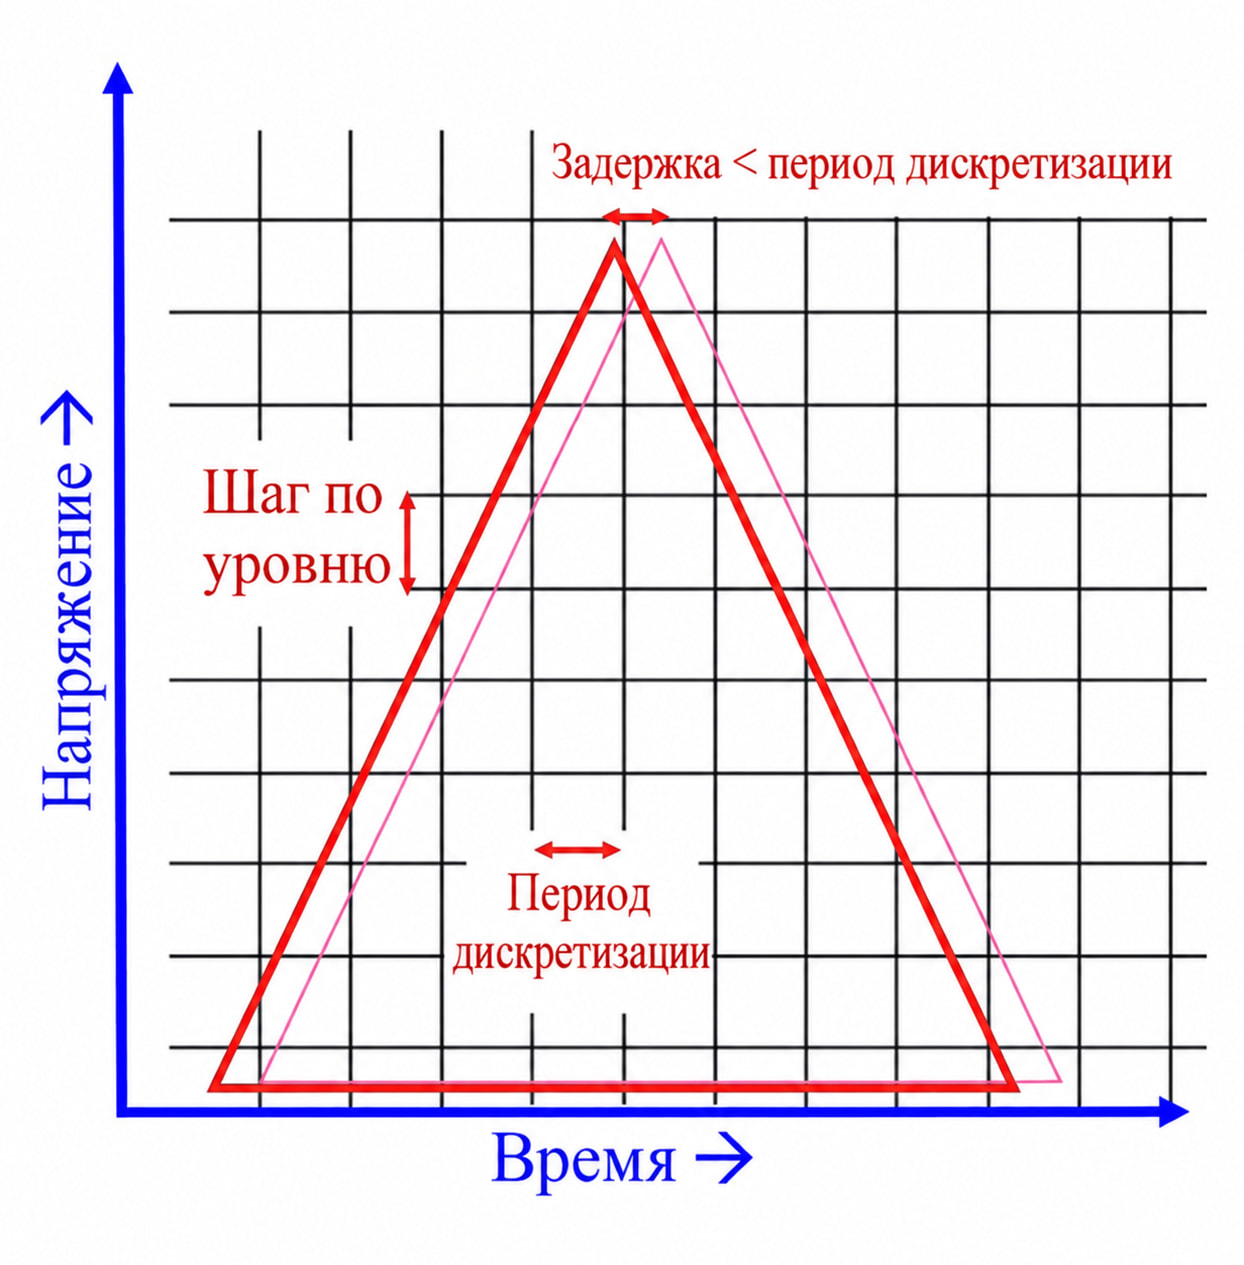

Рисунок 6. Различение временного сдвига в цифровом аудио. Задержку, или сдвиг во времени, треугольного сигнала на величину меньше периода дискретизации можно обнаружить как изменение цифровых значений отсчётов. Порог обнаружения τ* ≈ 1/(2ᴺf₍S₎) значительно меньше периода дискретизации 1/f₍S₎, но не характеризует минимальную длительность детали сигнала, которую можно разрешить. Это не «временное разрешение».

Разрешение низкоуровневых деталей

Временное размытие τ соответствует интервалу, за который сигнал падает от своего пикового значения до некоторой существенной доли от него — например, ½, 10%, 1/e и так далее. Два импульса, расположенные внутри этого интервала τ, невозможно различить. Но на рисунке 5б видно, что остаток исходного пика сохраняется гораздо дольше — порядка миллисекунды — и накладывается на последующую звуковую информацию.

Это не проявится как замедление атаки, но будет маскировать тихие детали. Можно ожидать, что влияние на звук окажется хуже, чем у случайного шума, поскольку этот остаток связан с самим сигналом. Восприятие глубины звуковой сцены использует слуховой механизм [1], сравнивающий интенсивность прямого и реверберационного звука; после времени реверберации последняя номинально на 60 дБ ниже. Маскирование этой информации уменьшает глубину и ощущение живого звучания. Такое длительное размытие можно оценивать по времени полного затухания τ₍C₎, за которое остаточный отклик исчезает полностью.

На рисунке 7 показаны основное, τ, и длительное, τ₍C₎, временное размытие в двух межблочных кабелях. Эти параметры в некоторой степени независимы друг от друга и могут даже изменяться в противоположных направлениях. Другой пример — акустическая система с хорошо согласованными по времени быстрыми динамиками, но недостаточно жёстким и плохо демпфированным корпусом. У неё будет короткое τ, но длительное τ₍C₎ из-за долго сохраняющихся вибраций корпуса.
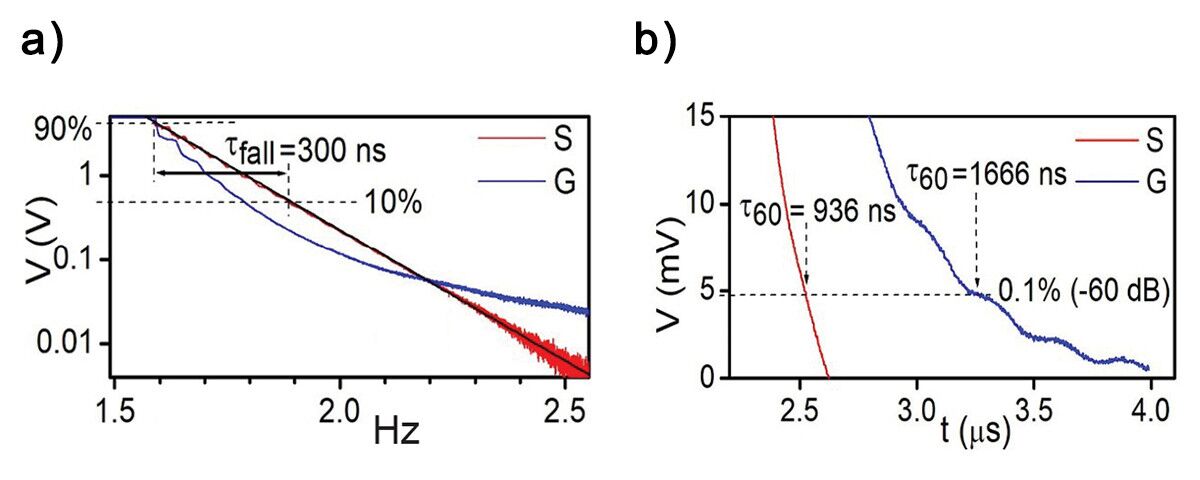

Рисунок 7. (а) Основное временное размытие, порядка сотен наносекунд, сильнее выражено у аудиофильского межблочного кабеля S, чем у обычного кабеля G. Однако у первого остаточный отклик полностью обрывается примерно за микросекунду, тогда как у кабеля G он сохраняется несколько микросекунд. (б) τ₆₀ — время, за которое уровень сигнала снижается на 60 дБ. Данные и рисунок адаптированы из источников [1, 18].

В стандартных технических характеристиках аудиооборудования сегодня не указывают τ и τ₍C₎. Возможно, их стоит включить в будущий, более полный набор характеристик. Величину τ₍C₎ следует определять по моменту, когда остаточный импульсный отклик становится настолько малым, что его уже невозможно измерить. Как мы увидим в следующей части этой серии, разрешающая способность уха превосходит даже астрономические масштабы: число возможных вариантов нейронного возбуждения улитки содержит на 17 нулей больше, чем число всех звёзд во Вселенной!

Оригинал — Hearing and Audio: Part 1 - Frequency, Phase, and Time | audioXpress

Источники и примечания

[1] М. Н. Кунчур. «Человеческая слуховая система и аудио». Applied Acoustics, том 211, статья 109507, 2023.
Опубликованная статья. Бесплатный препринт.

[2] Тембр, или звуковая окраска, — качество, позволяющее различать звуки одинаковой высоты, громкости и длительности.

[3] Если не указано иное, термин «искажение» используется в широком смысле и означает любое изменение формы сигнала.

[4] Дельта-функция Дирака содержит в своём спектре все частоты.

[5] М. Кунчур. «Тембр фортепианных нот при обычном и обратном воспроизведении», YouTube.

[6] Хотя изменяющийся во времени спектр, рассчитанный с коротким окном, может отчасти показывать происходящее, это довольно косвенный и сложный способ представить то, что уместнее отображать с помощью формы сигнала и спектрограммы.

[7] К. У. Бергер. «Некоторые факторы распознавания тембра». Journal of the Acoustical Society of America, том 36, с. 1888, 1963.

[8] Люди часто гордятся знанием формализма Фурье, но иногда это превращается в дурную привычку. Любой сигнал всегда можно преобразовать из временной области в частотную. Однако иногда такое преобразование не проясняет смысл, а скрывает существенную информацию.

[9] М. Кунчур. «Акустический закон Ома и влияние фазового сдвига и временной задержки на тембр», YouTube.

[10] Г. С. Ом. «Об определении тона и связанной с ним теории сирены и подобных устройств, создающих звук». Annalen der Physik und Chemie, том 59, с. 513–565, 1843.

[11] Г. Л. Ф. фон Гельмгольц. «Учение о слуховых ощущениях». Английский перевод четвёртого издания, выполненный А. Дж. Эллисом. Longmans, Green and Co., Лондон, 1912.

[12] Дополнительное обсуждение закона Ома приведено в разделе 3.8 статьи [1].

[13] Иногда его также называют сглаживающим фильтром, антиалиасинговым фильтром или фильтром подавления спектральных копий.

[14] Б. Лешовиц. «Измерение порога различения двух щелчков». Journal of the Acoustical Society of America, том 49, с. 462–466, 1971.

[15] В этих экспериментах использовалось оборудование, собственное быстродействие которого могло ограничивать точность измерений. Чтобы определить предельное TR, эксперименты необходимо повторить на современном оборудовании HEA. Нейрофизиологическое моделирование, описанное во второй части этой серии — «Разрешающая способность слуха», — предполагает, что возможно TR ≈ 1 мкс.

[16] Muse Audio USB Mini DAC. Другие испытанные ЦАП и CD-проигрыватели отличались в деталях, но имели сопоставимую полную ширину импульсного отклика на половине максимума — FWHM.

[17] При N = 16, где N — разрядность, то есть разрешение по вертикальной оси, и f₍S₎ = 44,1 кГц, где f₍S₎ — частота дискретизации, получаем:

τ* ≈ 1/(2¹⁶ × 44 100) = 0,35 нс.

[18] М. Н. Кунчур. «Кабельные соединения между аудиокомпонентами могут влиять на воспринимаемое качество звука». Journal of the Audio Engineering Society, том 69, № 6, с. 398–409, 2021.
18 лайков

Слух и аудио. Часть 2: разрешающая способность слуха

Наш слух — преобразование звука в нервные сигналы и обработка этих сигналов — устроен гораздо сложнее, чем многие из нас представляют. Эта серия из двух статей знакомит с новейшими результатами исследований слуха и рассматривает, как они влияют на наши представления о максимально точном воспроизведении музыки. Вторая статья посвящена разрешающей способности слуха, порогам обнаружения различий и последствиям для слепых тестов.

Как отмечалось в первой части этой серии — «Частота, фаза и время», — часть скептицизма в отношении аудио высокого класса, high-end audio (HEA), основана на недостаточном понимании работы слуха. Это непонимание приводит к неправильно организованным слепым прослушиваниям и самоисполняющемуся пророчеству: результаты могут ошибочно подтверждать несостоятельность заявлений о преимуществах HEA. Следующее изложение представляет собой упрощённую и сокращённую выдержку из обстоятельной обзорной статьи [1]. Читателям, желающим разобраться глубже, следует обратиться к этому обзору, другим цитируемым работам и статьям на сайте автора.

Физиология человеческого уха

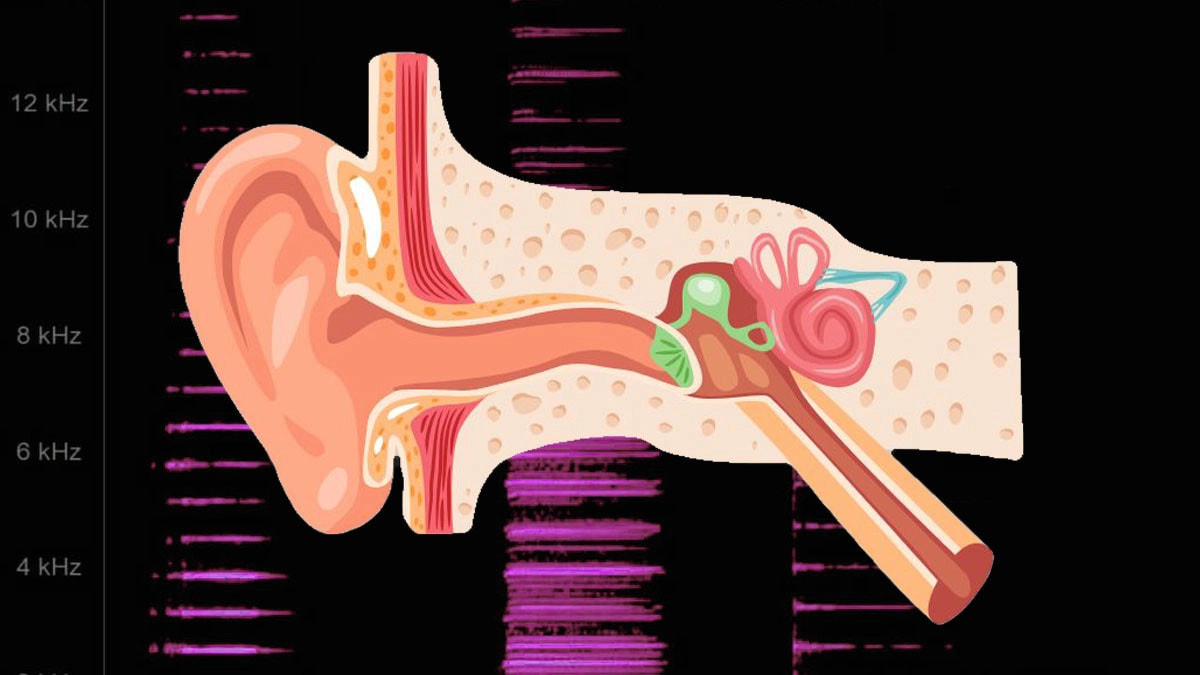
На рисунке 1 показано человеческое ухо в разрезе. После прохождения ряда нелинейных и активно регулируемых этапов в наружном и среднем ухе звуковые колебания попадают в заполненную жидкостью улитку. Они распространяются по лестнице преддверия, разворачиваются у дальнего конца — верхушки — и возвращаются по барабанной лестнице, прежде чем вновь выйти в среднее ухо. Эта бегущая волна вызывает колебания базилярной мембраны, на которой расположены 3500 рядов волосковых клеток.

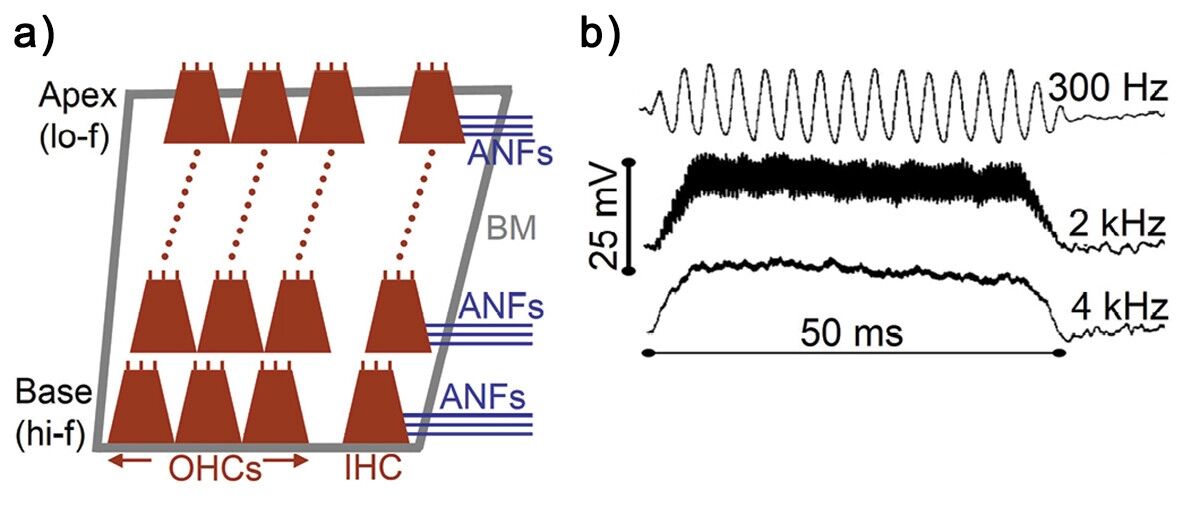
На рисунке 2 показан участок базилярной мембраны. Её форма и свойства меняются по длине: высокие частоты вызывают максимальный резонанс вблизи входа — овального окна, — а низкие частоты — вблизи дальнего конца, верхушки. Эта структура работает как нелинейный, чрезвычайно сложный 3500-канальный анализатор спектра — и выполняет другие функции. На напряжение, создаваемое внутренними волосковыми клетками (IHC), работающими подобно микрофонам, влияют пять ступеней активной обратной связи.

Последующая обработка в нервной системе выполняет многочисленные спектрально-временные анализы, выявляя взаимосвязи между каналами, например относительные моменты начала звуковых составляющих. Поэтому упрощённый спектральный анализ аудиооборудования позволяет лишь в самой малой степени предсказать его звучание.


Рисунок 1.
(а) Человеческое ухо в разрезе. В наружном ухе звук поступает через ушную раковину, проходит по слуховому проходу и на барабанной перепонке преобразуется в механические колебания. В среднем ухе эти колебания проходят механическое и гидравлическое усиление, прежде чем через овальное окно передаются в улитку.
(б) Улитка в разрезе. Колебания поступают через овальное окно в лестницу преддверия, распространяются до верхушки и возвращаются по барабанной лестнице. Эта бегущая волна вызывает колебания базилярной мембраны, расположенной между барабанной лестницей и улитковым протоком — средним каналом.
Рисунок адаптирован из источника [1].


Рисунок 2.
(а) Участок базилярной мембраны с несколькими рядами волосковых клеток. Внутренние волосковые клетки (IHC) работают подобно «микрофонам» и создают напряжение в ответ на колебания. Наружные волосковые клетки (OHC) работают подобно «громкоговорителям»: создавая звук и движение, они активно усиливают или ослабляют отклик внутренних волосковых клеток — в некотором роде как наушники с активным шумоподавлением. Каждая внутренняя волосковая клетка настроена на свою частоту. Вся система работает как 3500-канальный анализатор спектра.
(б) Выходное напряжение внутренних волосковых клеток [3]. В высокочастотных каналах на протяжении звучания возникает плато: информация о фазе отдельных периодов отсутствует, сохраняется лишь временная информация о начале звука на этих частотах.
Рисунок адаптирован из источника [1].

Разрешение деталей

3500 «аналоговых», то есть непрерывно меняющихся, напряжений внутренних волосковых клеток представлены «оцифрованной» картиной импульсной активности 30 000 волокон слухового нерва. В совокупности она называется паттерном нейронного возбуждения, или NEP. Объём информации, представленный этой картиной в каждый момент времени, настолько огромен, что назвать его «астрономическим» — значит оскорбить ухо. Очень осторожная оценка нижней границы [1] разрешения деталей, то есть числа возможных вариантов, составляет:

RD > 10⁴⁰.

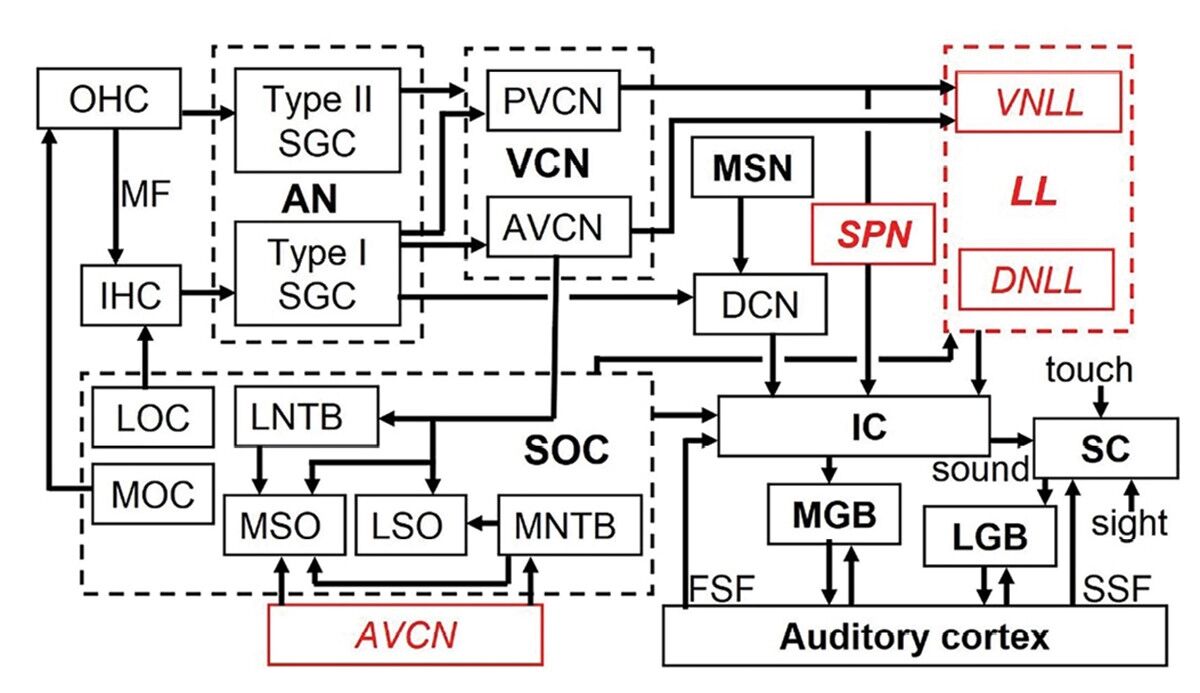
В этом числе на 17 нулей больше, чем в числе всех звёзд во Вселенной! [2] Эта информация проходит масштабную обработку в нервной системе, как показано на рисунке 3. Блок-схема приведена здесь, чтобы дать представление о невероятной сложности нейрофизиологии человеческого слуха; подробное описание её работы дано в другом источнике [1].


Рисунок 3. Аналоговые, то есть непрерывно меняющиеся, рецепторные напряжения, возникающие во внутренних волосковых клетках (IHC), «оцифровываются» и передаются по слуховому нерву (AN) к заднему вентральному (PVCN), переднему вентральному (AVCN) и дорсальному (DCN) улитковым ядрам.

Путь AVCN → MSO выявляет бинауральные межушные разности времени (ITD) для каждой частоты. Путь PVCN → VNLL выявляет монауральные временные различия между началами разных частотных составляющих в каждом ухе. Эта обработка происходит в стволе мозга. Другие пути и общий анализ в нервной системе подробно описаны в источнике [1].

Сокращения на схеме:

  • SOC — верхний оливарный комплекс;

  • MSO — медиальная верхняя олива;

  • LL — латеральная петля;

  • VNLL — вентральное ядро латеральной петли;

  • DNLL — дорсальное ядро латеральной петли;

  • SGC — клетка спирального ганглия;

  • OHC — наружная волосковая клетка;

  • MF — механическая обратная связь;

  • MSN — соматосенсорное ядро продолговатого мозга;

  • SPN — верхнее параоливарное ядро;

  • LNTB — латеральное ядро трапециевидного тела;

  • LSO — латеральная верхняя олива;

  • LOC — латеральная оливокохлеарная система;

  • MOC — медиальная оливокохлеарная система;

  • IC — нижние холмики;

  • SC — верхние холмики;

  • MGB — медиальное коленчатое тело;

  • LGB — латеральное коленчатое тело;

  • FSF — обратная связь, повышающая частотную избирательность;

  • SSF — обратная связь, повышающая пространственную избирательность.

Рисунок адаптирован из источника [1].

Огромный объём подробной информации в паттерне нейронного возбуждения создаёт проблему для слепых прослушиваний. Традиционные быстрые тесты A–B основаны на предположении, что при длительном промежутке между A и B испытуемый может забыть первый звук. Это ошибка, поскольку при таком подходе испытуемый опирается на кратковременную память, которая сохраняет информацию до 15–30 секунд и способна удерживать лишь около четырёх элементов. Такой метод может хорошо работать, когда в простом звуке меняется один параметр, например при определении едва заметного различия частоты чистого тона — JND.

Однако изменения тембра из-за искажений в аудиотракте связаны с множеством тонких изменений паттерна нейронного возбуждения. Они выходят за пределы возможностей кратковременной памяти. Чтобы усвоить эту подробную информацию, необходимо долго слушать сложную музыку, делая между A и B паузу длительностью не менее минуты — своего рода «очищение восприятия». Это сбрасывает кратковременную память и задействует устойчивую, несравнимо более подробную долговременную память. Такой подход, основанный на длительных многократных прослушиваниях — extended-multiple-pass, EMP, — привёл к историческому доказательству того, что кабельные соединения между аудиокомпонентами дают слышимые различия [3].

Временное разрешение

В первой части этой серии обсуждалась ошибочная практика принимать обратную величину характерной частоты, 1/f₍C₎, за характерное время τ. Такой подход не всегда работает даже для физических систем, а применительно к слуху он ещё менее надёжен.

Упрощённо говоря, в слухе действуют два вида временного разрешения. Первый — бинауральная межушная разность времени, ITD, то есть различие времени поступления звука заданной частоты в два уха. Второй — монауральное разрешение переходных процессов, TR, то есть различие времени поступления разных частотных составляющих в одно ухо. Им соответствуют основные пути AVCN → MSO и PVCN → VNLL, показанные на рисунке 3.

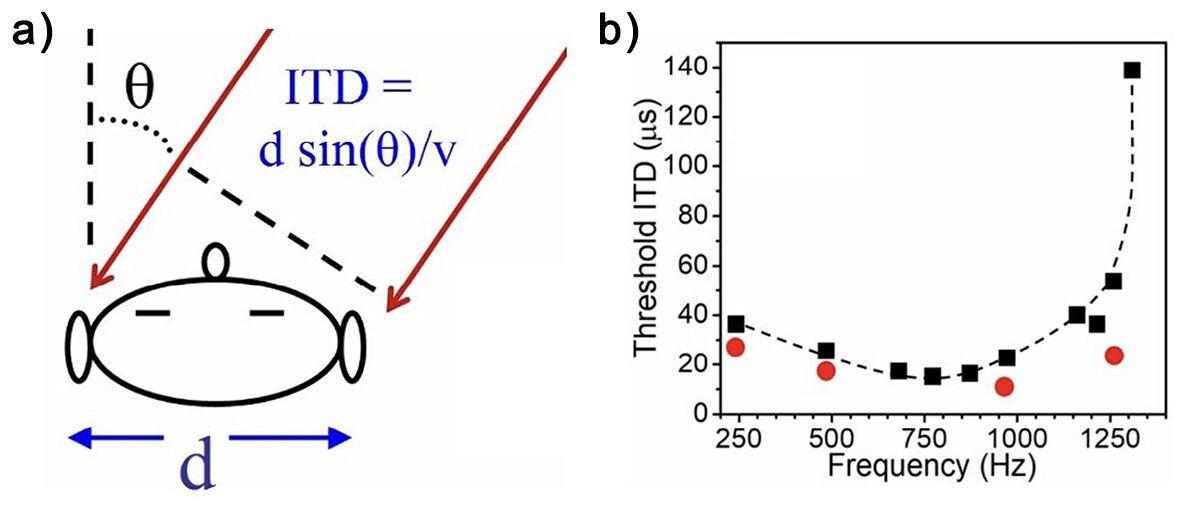
Сначала рассмотрим бинауральную ITD. Как показано на рисунке 4а, звук, приходящий прямо спереди — при азимутальном угле θ = 0, — достигает обоих ушей одновременно. При других направлениях он приходит с относительной задержкой:

ITD = d sin(θ)/v.

На рисунке 4б приведены классические результаты опубликованных слепых прослушиваний [5, 6], определивших порог обнаружения ITD на различных частотах. Обратите внимание: наименьшая различимая ITD — около 9 мкс при частоте около 900 Гц — составляет одну сотую периода! На более высоких частотах порог ITD, напротив, хуже: например, около 140 мкс при 1400 Гц. Это противоречит привычному ожиданию, что более высоким частотам соответствуют более короткие времена отклика.

Рисунок 4.
(а) Межушная разность времени (ITD) для звука, приходящего сбоку, вызвана геометрической задержкой d sin(θ)/v, где θ — азимутальный угол, d — расстояние между ушами, а v — скорость звука.
(б) Слепые прослушивания — психоакустические эксперименты — установили [4, 5], что ITD обнаруживается с микросекундной точностью.
Рисунок адаптирован из источника [1].

Точность передачи тембра в аудио преимущественно связана с монауральным разрешением переходных процессов, TR. В первой части этой статьи — март 2024 года — мы увидели, что ключевую роль играют относительные моменты начала разных частотных составляющих и атака, а также другие этапы огибающей. В мозге существуют специальные нейронные цепи, выявляющие эту синхронность между частотами.

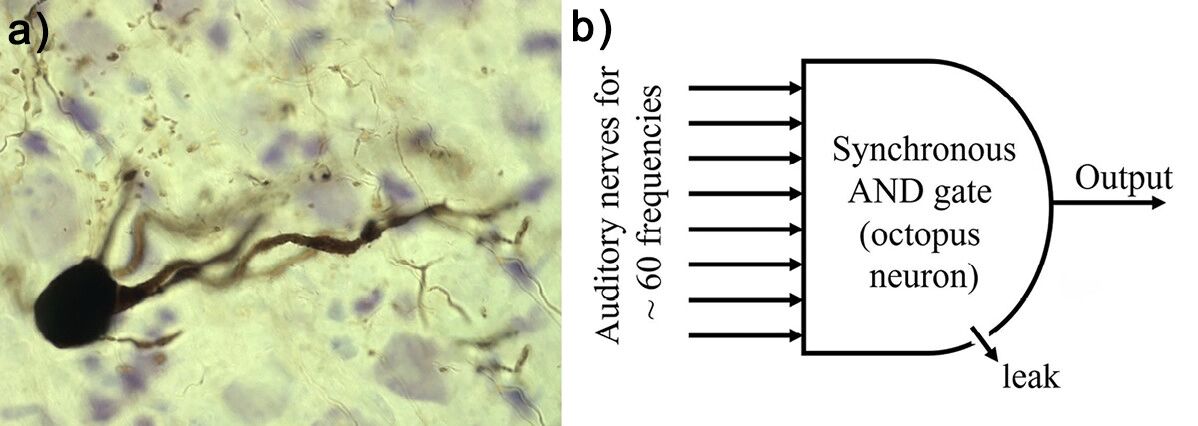
Процесс обнаружения, определяющий TR, начинается с октопусных клеток (OC) в заднем вентральном улитковом ядре, PVCN, — см. рисунок 3. На рисунке 5а показана октопусная клетка. Её дендриты, то есть «входы», расположены перпендикулярно волокнам слухового нерва, что позволяет объединять информацию из широкого диапазона частотных каналов. Работая как синхронный логический элемент «И», клетка выдаёт импульс, когда сигналы на её входах поступают вместе в пределах узкого временного окна.


Рисунок 5.
(а) Изображение октопусной клетки — одного из основных нейронов заднего вентрального улиткового ядра, PVCN.
(б) Этот нейрон работает как синхронный логический элемент «И»: благодаря утечке через клеточную мембрану заряд от каждого входного сигнала быстро затухает. Вероятность выходного импульса отражает произведение перекрывающихся во времени вероятностей входных импульсов от разных частот и тем самым характеризует резкость звукового переходного процесса. Подробный анализ [1] обработки в пути PVCN → VNLL — см. рисунок 3, — учитывающий такие параметры, как входные сопротивления дендритов и клеточные постоянные времени, даёт оценку монаурального разрешения переходных процессов TR ≈ 1–10 мкс.

Подробный анализ нейронных процессов [1] оценивает итоговое разрешение переходных процессов как TR ≈ 1–10 мкс. Это хорошо согласуется с экспериментальным порогом 4–10 мкс, установленным в психоакустических измерениях Лешовица, которые обсуждались в первой части. Существенно, что TR не связано тесно с самой высокой частотой, которую способен слышать конкретный человек. Поэтому пожилой аудиофил, не слышащий частоты выше нескольких килогерц, всё ещё может различать особенности временной структуры в микросекундном диапазоне.

Заключение

Эта серия из двух статей даёт краткий обзор сложности, чувствительности и разрешающей способности человеческой слуховой системы. Она создаёт более обоснованную основу для обсуждения точности воспроизведения звука и помогает развеять множество ошибочных, глубоко укоренившихся предположений, распространённых в некоторых частях аудиосообщества.

Заинтересованным читателям настоятельно рекомендуется ознакомиться с более подробными работами, которые можно бесплатно скачать с сайта автора. В частности, упомянутый обзор слуха [1] необходим всем, кто хочет правильно понять, что происходит в нашем мозге после того, как звук достигает ушей.

Оригинал — Hearing and Audio: Part 2 - Auditory Resolution | audioXpress

Источники и примечания

[1] М. Н. Кунчур. «Человеческая слуховая система и аудио». Applied Acoustics, том 211, статья 109507, 2023. Бесплатный препринт.

[2] Максимальное значение может достигать RD ≈ 10⁸⁰, что примерно соответствует общему числу атомов во Вселенной!

[3] А. Р. Палмер и И. Дж. Расселл. «Фазовая синхронизация в улитковом нерве морской свинки и её связь с рецепторным потенциалом внутренних волосковых клеток». Hearing Research, том 24, № 1, с. 1–15, 1986. PMID: 3759671. DOI.

[4] М. Н. Кунчур. «Кабельные соединения между аудиокомпонентами могут влиять на воспринимаемое качество звука». Journal of the Audio Engineering Society, том 69, № 6, с. 398–409, 2021. DOI. Бесплатный препринт доступен на сайте автора.
[5] Р. Б. Клампп и Г. Р. Иди. «Некоторые измерения порогов межушной разности времени». Journal of the Acoustical Society of America, том 28, с. 859–860, 1956. DOI.

[6] А. Бругера, Л. Дунай и У. М. Хартманн. «Пороги межушной разности времени у человека для синусоидальных тонов: высокочастотный предел». Journal of the Acoustical Society of America, том 133, № 5, с. 2839–2855, май 2013 года. Указано как рисунок 1(в). DOI. PMID: 23654390; PMCID: PMC3663869.

16 лайков

Сложно, но интересно. Затрагивает чувства теоретиков и измерителей.
Токма для расширения кругозора.

3 лайка

Требует вернуться и перечитать…

1 лайк

Вот исходный препринт

THE HUMAN AUDITORY SYSTEM AND AUDIO .pdf (3.2 MB)

1 лайк

Объективисты лютуют, им такое не нравится. А временная точность — ключ к вовлеченному прослушиванию. Но им некогда, они точат DSP-пилу, чтобы ампутировать себе слух.

Мне кажется, он слишком зацикливается на важности эффектов временной области в ущерб частотной характеристике. Конечно, и то, и другое важно (поэтому я рекомендую использовать современные методы коррекции акустики помещения с помощью DSP для оптимизации во временной и частотной областях), но всё же, я подозреваю, что большинство слушателей сочли бы систему, способную воспроизводить частоты в диапазоне 20 Гц-20 кГц, более реалистичной, чем способность системы обрабатывать, скажем, 5-10 мкс временной и фазовой когерентности при воспроизведении музыки.

2 лайка

Что такое интенсивность?
И стремление к живому звуку, это как? Сидящий на балконе и мсидящий в партере слышат по разному

Объективисты как раз радостно измеряют временные характеристики и приводят их к идеалу с помощью DSP, что невозможно к примеру в пассивных АС, сколько бы они ни стоили. Ссылку на видео по этому вопросу я уже здесь приводил…

Лечат и колечат, да. Наслышаны.
Почему DSP-шники всегда упирают на цену? Потому что коррекция беслпатная?

1 лайк

Очень интересно, но по поверхностному просмотру больше про слух, разрешение и верх, чем про “низ”, “середину”, интонации и долговременный анализ слухом результатов. Нужно внимательнее перечитатать, безусловно.

Тема непростая, да и перевод тоже сложный :man_facepalming:

2 лайка

А если медведь в детстве наступил ?! Слуха нет от природы , то лучше и не слушать :ear: ?!

Как раз и нужно слушать. Частоты можешь ты не слышать, но тайминги слушать ты обязан :index_pointing_up:

3 лайка

Статья правильная. Куцо сублимирую:
при сведении АС в первую очередь стремимся к подражанию широкополосному динамику или микрофону в плане минимальной фазы, что есть очень грубо: фаза формой должна напоминать АЧХ, но с неким минимальным наклоном в сторону НЧ, в результате чего с понижением частоты начало сигнала немного запаздывает. В истинно минимальнофазовых (см.выше) системах это запаздывание практически не слышно и на этом следует останавливаться. Если же сведено только по АЧХ в ущерб фазе (почти всё), то прибегают к ФИР-коррекции, чтобы привести фазу на СЧ к линейной, а на НЧ к минимальной, на НЧ так — в силу мощности процессора.

Я бы вынес в лозунг, что АЧХ сильно заспамленный термин, с ней нет проблем, а вылизывание её не ведёт к натуральному или же присутствующему звуку.
Волноваться нужно о времени, потому что фильтры = время, комната = время, сигнал = время. А время — это и есть то, насколько сильно наклонилось фаза к нижнему слышимому звуку на НЧ. В двухполоске это могут быть сотни градусов, в трёхполоске больше, и только в ШП можно говорить о десятках градусов. Если же подключить к двухполоске сабвуфер, то убегание перевалит за тысячу градусов, потому что диапазон расширился ниже, а фильтров увеличилось. Именно время (фаза) заставляет выключать сабвуфер при прослушивании музыки. Звук пишется на минимальнофазовых микрофонах, а чрезмерная фильтрация, которая неизбежно появляется при увеличении полос, полностью убивает звук.
Уже не коротко, а сказал не всё. Извините.

2 лайка

Дмитрий! Спасибо за статью.
Если осмыслить всё, то статья не только и не столько “про тайминги” - то есть интервалы времени между событиями. Она про высокую чувствительность слуха во временном домене. Важнейший аспект воспроизведения, который в ней обозначен, - важность точности воспроизведения формы сигнала (во времени). И всё, что из этого вытекает - прежде всего требования к частоте дискретизации, необходимой, чтобы передать форму в границах чувствительности слуха.

Это отдельный вопрос :slight_smile:

На многих уровнях :sob:

Вообще нет. Это всё тот же вопрос. Но любой имеет право настаивать на своих заблуждениях бесконечно. :smiley: Желающие думать и разбираться подумают и разберутся, желающие воровать и заблуждаться продолжат заблуждаться. :smiley:

Есть вопрос резки и склейка кусочков.
Есть вопрос поставки кусочков вовремя.

Думается, что размер кусочков с некоторого значения становится менее важным чем поставка вовремя.

Если мы говорим про нормальные, аналоговые источники, то там свои заморочки.

Тогда отвечу в Вашей палитре аналогий.
Есть вопрос формы кусочков. И он не менее важен, чем их своевременная доставка.